更新日期:2026 年 10 月 17 日。技术篇第 1 至 5 章。第一章此前已通过且正文未改;前五章已整体自审,按用户要求暂定。
本篇讲直接 Text-to-SQL 与语义 DSL 的基本原理、语义模型的组成和查询约束,再讨论方案选择与系统分工。第六章合并项目范围、引擎介绍与环境接入,作为实战篇开篇,不在本合订稿中。语义 SQL 与统一执行计划仍留到高级篇。
| 章节 | 单章入口 |
|---|---|
| 第 1 章 从自然语言到 SQL | 正文 |
| 第 2 章 SQL 能执行结果为什么仍可能不对 | 正文 |
| 第 3 章 语义层的作用与代价 | 正文 |
| 第 4 章 自然语言到 DSL 再到 SQL | 正文 |
| 第 5 章 怎样选择和组织问数方案 | 正文 |
“帮我查一下,2025 年 6 月销售额最高的三个客户是谁。”
把问题、表结构和业务说明交给 AI,让它生成 SQL,再由查询工具执行,就是本章介绍的 Text-to-SQL 路线。
本章使用 SQLite 和自编的虚构销售数据。销售额按有效发票总金额累计,月份按开票日期统计,只计算 ISSUED 状态。
金额以分保存,按人民币元展示时除以 100,因为 100 分等于 1 元;原本以元保存则无需换算。日期使用同一时区,格式为 YYYY-MM-DD HH:MM:SS。
实际项目中,应先从业务负责人、字段说明或已有报表确认这些口径。
客户表 customers:
| 字段 | 含义 |
|---|---|
customer_id |
客户 ID,主键 |
customer_name |
客户名称 |
发票表 invoices:
| 字段 | 含义 |
|---|---|
invoice_id |
发票 ID,主键 |
customer_id |
对应客户表的客户 ID |
invoice_date |
开票日期,可能包含时分秒 |
total_amount_cents |
发票总金额,单位为分 |
status |
ISSUED 表示有效,CANCELLED 表示作废 |
一位客户可以有多张发票,两表通过 customer_id 关联。将上述结构和下面的要求一并交给 AI,也可以让它先通过工具读取表结构:
请用 SQLite 查询 2025 年 6 月有效发票金额最高的三个客户。按开票日期统计,只计算 ISSUED 状态,金额从分换算为元。返回客户 ID、名称和销售额,金额相同按客户 ID 升序。
对应的查询如下:
SELECT
    c.customer_id,
    c.customer_name,
    ROUND(SUM(i.total_amount_cents) / 100.0, 2) AS sales_amount
FROM invoices AS i
JOIN customers AS c
    ON c.customer_id = i.customer_id
WHERE i.status = 'ISSUED'
  AND i.invoice_date >= '2025-06-01'
  AND i.invoice_date < '2025-07-01'
GROUP BY c.customer_id, c.customer_name
ORDER BY sales_amount DESC, c.customer_id ASC
LIMIT 3;
i、c 是表别名。查询通过 JOIN 关联客户,用 WHERE 筛选有效发票,再按客户分组求和、排序取前三名。
时间范围写成“大于等于 6 月 1 日、小于 7 月 1 日”,可以包含六月最后一天带时分秒的记录。
/ 100.0 将分换算为元,例如 300000 分对应 3000 元;ROUND(..., 2) 将结果四舍五入到小数点后两位。
生成 SQL 后,由数据库客户端或应用提供的查询工具执行,得到真实结果:
flowchart LR
    A[问题和表结构及业务说明] --> B[AI 生成 SQL]
    B --> C[查询工具执行 SQL]
    C --> D[数据库返回结果]
    D --> E[AI 整理回答]
本例结果如下:
| 客户 ID | 客户名称 | 销售额(元) |
|---|---|---|
| 1 | 华东食品 | 5500.00 |
| 2 | 远山商贸 | 4200.00 |
| 3 | 青禾便利 | 3000.00 |
可以逐笔核对:华东食品的两张有效发票分别为 3000 元和 2500 元,合计 5500 元。北辰超市六月有一张 99999 元的作废发票,已被排除。
AI 整理回答时,应同时说明统计月份、使用开票日期和排除作废发票的口径。
从这个例子可以看出,Text-to-SQL 首先要通过提示词向 AI 解释数据库的表、字段和关系,让它理解数据结构,再结合业务口径生成查询。
这些信息可以人工整理,也可以由程序读取元数据后补充到提示上下文中。表结构之外,还要说明状态编码、日期口径和金额单位,才能把“销售额”这样的业务说法对应到具体字段与计算方式。
已有 Java 源码时,可以让 AI 先整理提示词草稿:
@Column 指定属性与数据库列的映射。resultMap,提取字段映射、关联与筛选条件。枚举和业务代码还能补充状态含义与计算规则。可以这样交代:
请阅读客户、发票相关的实体类、Mapper、SQL 和业务代码,整理表、字段、主键及关联,补充金额单位、状态、日期和计算规则。注明来源文件与位置,不确定的列为待核对项,输出供 Text-to-SQL 使用的提示词草稿。
再由人核对源码是否对应当前数据库,以及关联、单位和业务含义是否准确。这样可以减少逐表逐字段编写说明的工作。
把问题改成“2025 年 7 月销售额最高的两个客户”,调整时间上下界和条数限制,再核对结果。
将建表与数据、查询和复跑脚本放在同一目录,安装 Python 3 后进入该目录运行:
python -X utf8 verify.py
脚本使用 Python 自带的 SQLite,在内存中建库,核对六月查询和七月练习,输出结果并保存为 chapter-01-results.json。
这次 Text-to-SQL 查询中,AI 承担了以下工作:
| 环节 | AI 在本例中需要完成的工作 |
|---|---|
| 理解问题 | 确定月份、汇总对象和前三名要求 |
| 匹配表和字段 | 从结构说明中选择客户、发票及所需字段 |
| 确定关联与粒度 | 按客户 ID 关联,每张有效发票金额只累计一次 |
| 展开计算规则 | 确定有效状态、时间边界和金额求和方式 |
| 按需换算金额单位 | 以分保存、按元展示时,将金额合计除以 100.0;原本以元保存则无需换算 |
| 生成 SQL | 按 SQLite 语法组织关联、筛选、分组、计算、排序和条数限制 |
| 根据结果回答 | 根据查询结果说明客户排名、金额和统计口径 |
查询工具提交 SQL,数据库执行数据读取与计算,AI 再根据结果组织回答。后面对比 DSL 路线时,可以逐项看哪些工作仍由 AI 完成,哪些定义交给语义模型和查询引擎。
下一章加入发票明细,看看 SQL 正常执行时,金额为什么仍可能算错。
上一章,青禾便利六月的销售额是 3000 元。这次增加一个要求:“把商品明细行数也列出来。”
查询关联发票明细表后,SQL 正常执行,青禾便利却变成了 6600 元,排名超过了远山商贸。
统计口径沿用上一章:按开票日期统计六月有效发票的总金额。
新增的 invoice_lines 每行代表一条商品明细,通过 invoice_id 关联发票;line_id 是明细 ID,line_amount_cents 是明细金额,单位为分。本题统计明细行数,与商品销售件数不同。
如果直接关联明细,再按客户累计发票金额、统计行数,会得到下面的查询:
SELECT
    c.customer_id,
    c.customer_name,
    ROUND(SUM(i.total_amount_cents) / 100.0, 2) AS sales_amount,
    COUNT(d.line_id) AS detail_line_count
FROM invoices AS i
JOIN customers AS c
    ON c.customer_id = i.customer_id
LEFT JOIN invoice_lines AS d
    ON d.invoice_id = i.invoice_id
WHERE i.status = 'ISSUED'
  AND i.invoice_date >= '2025-06-01'
  AND i.invoice_date < '2025-07-01'
GROUP BY c.customer_id, c.customer_name
ORDER BY sales_amount DESC, c.customer_id ASC;
为方便核对,这次列出本期所有有有效发票的客户:
| 客户 | 销售额(元) | 商品明细行数 |
|---|---|---|
| 华东食品 | 11000.00 | 4 |
| 青禾便利 | 6600.00 | 4 |
| 远山商贸 | 4200.00 | 1 |
| 南桥百货 | 1800.00 | 2 |
远山商贸的金额没变,其他客户却被多算了。
华东食品的 1002 号发票共 3000 元,有两条明细。关联结果如下,金额已换算成元:
| 发票 ID | 明细 ID | 发票总金额(元) | 明细金额(元) |
|---|---|---|---|
| 1002 | 21 | 3000.00 | 1200.00 |
| 1002 | 22 | 3000.00 | 1800.00 |
一张发票关联成两行,两行都带着 3000 元的发票总金额,SUM(i.total_amount_cents) 就把它加成了 6000 元。华东食品的两张发票各有两条明细,因此 5500 元变成了 11000 元。
青禾便利的一张 1800 元发票有三条明细,另一张 1200 元发票有一条,错误结果是 1800 × 3 + 1200 = 6600 元。
这就是粒度问题:一行代表一张发票,还是一条商品明细。数据库按关联后的行求和,查询编写者需要保证发票金额每张只计一次。手写 SQL 同样可能犯这个错误。
先按发票统计明细条数,让中间结果每张发票只剩一行,再关联回来。将原来的明细 JOIN 替换为:
LEFT JOIN (
    SELECT invoice_id, COUNT(*) AS detail_line_count
    FROM invoice_lines
    GROUP BY invoice_id
) AS d
    ON d.invoice_id = i.invoice_id
SELECT 中原来的 COUNT(d.line_id) 也要改为累加已汇总的明细条数:
SUM(COALESCE(d.detail_line_count, 0)) AS detail_line_count
日期、状态和金额求和保持原样,完整 SQL 见修正查询。每张发票只关联一行统计结果;没有明细时,LEFT JOIN 保留发票,COALESCE 将条数按零处理。
结果恢复为:
| 客户 | 销售额(元) | 商品明细行数 |
|---|---|---|
| 华东食品 | 5500.00 | 4 |
| 远山商贸 | 4200.00 | 1 |
| 青禾便利 | 3000.00 | 4 |
| 南桥百货 | 900.00 | 2 |
本样例直接累计 line_amount_cents 也能对上,因为明细合计与发票总金额一致。这里保留发票口径,同时增加明细条数;实际项目中需先确认两种金额是否一致。
还有一种看似省事的改法:
SUM(DISTINCT i.total_amount_cents)
当前样例恰好能算对,但 DISTINCT 去重的是金额值。
给华东食品增加一张 ID 为 1099、金额为 3000 元的有效发票后,三张发票应合计 3000 + 2500 + 3000 = 8500 元。金额去重后却只剩 5500 元。
要判断是否同一张发票,应看发票 ID;两张发票金额相同,也需要分别累计。
避开重复累计,还不等于选对了业务口径:用户问订单金额,却查了发票金额;同样叫“销售额”,也可能有含税、未税之分。
日期也会漏数:若结束条件写成 invoice_date <= '2025-06-30',月底 23:59:59 的发票就会被漏掉,青禾便利只剩 1800 元。
空结果也不能直接解释为“没有销售”,还需检查筛选、数据覆盖范围和刷新时点。
教学库的 total_amount_cents 把单位写在了字段名里,真实业务库未必这么清楚。假设 order_amount 存的是分,service_fee 存的是元,同样保存 1000,分别表示 10 元和 1000 元。查询两个字段时,不能统一除以 100。
即使提示词逐项说明,LLM 仍可能漏掉分转元,或把已经是元的字段再除一次。说明能帮助选对字段,却不能代替实际执行换算的计算规则。
旧字段也是陷阱:两个金额字段名字相似,其中一个却早已停止更新。选错后 SQL 照样能执行,数值还可能看着挺像那么回事。字段名、注释和样例值都要结合业务核实。
直接基于物理表生成 SQL,AI 通常需要相关结构和字段说明;工具若开放 Schema 浏览或展示 SQL,使用者也会接触这些物理细节。
说点不那么规范的:有时候写代码写烦了,我也会给字段起个 xxx_*** 之类的名字,或者加点不方便在客户面前念出来的前缀。这些名字留在库里还好,出现在问数界面上,可能就得先解释一下当时的精神状态了。大家还是多遵守命名规范,出来混都是要还的,指不定哪天就社死了。
准备查询数据时,应只提供当前主题所需的表和字段,排除过时字段;把常用换算、计算和过滤写成可复用的 SQL 表达式或视图,再用简短说明补充业务歧义。表结构或口径变化后,这些定义也要维护。Databricks 的实践建议同样优先采用结构化定义和查询示例,避免把所有规则堆进文字说明。
前面只加了一次关联,就需要展开记录才能看清错误。再增加多层子查询、CTE、UNION 和计算字段,复核就要逐层追查字段来源、过滤位置和聚合粒度。
权限条件也有位置之分:把右表的权限条件直接放进 WHERE,可能让 LEFT JOIN 丢掉本应保留的无匹配记录;先计算全公司的前三名再过滤,也不等于本部门的前三名。
Text-to-SQL 可以通过数据库行级策略、受限视图或查询服务落实权限。数据库策略需要身份映射与配置;查询服务自行解析、改写 SQL,则要处理表、别名、子查询和分支。复杂 SQL 增加的是这类改写与验证成本,不意味着数据库原生权限也必须逐条改写查询。数据库行级策略示例、查询引擎权限示例。
权限必须来自可信身份和授权配置,不能根据用户在对话里自报的部门判断,也不能只要求 AI 记得加条件。
跨表探索可能需要较宽的只读范围,但仍须按工作需要授权。只读限制写入,不等于限制能读取哪些人的数据。
本例可以逐笔核对发票金额,按发票 ID 检查是否重复累计;实际项目也要对照原始记录或已确认的报表,核对口径、粒度和结果。AI 可以辅助审查,但让它再解释一遍自己生成的 SQL,还不能算完成了复核。
按样例说明中的第 2 章,将所需的六个文件放在同一目录,运行:
python -X utf8 verify-chapter-02.py
脚本在独立内存库中核对基础样例和边界情况,结果写入 chapter-02-results.json,不修改第一章原始数据。
讲到这里,Text-to-SQL 的实现与限制应该更清楚了:LLM 熟悉 SQL,不代表它熟悉你的数据库。字段含义、业务口径和权限范围,需要有人确认、由系统落实,并用真实数据核对。
下一章介绍怎样把可复用的业务定义组织为语义模型,让其中已经确认的规则由引擎重复执行。
前两章为了查出六月客户销售额,已经确认了不少事情:金额来自发票,按开票日期筛选,只统计有效发票,分转元,每张发票只累计一次。
换成七月、按月份统计,这些规则大多仍然适用。我们希望建立的语义层,能让 AI 理解这些业务含义,正确调用查询,并依据实际结果如实回答用户。为此,系统需要提供可复用的定义、执行规则,以及 AI 能理解的查询接口和返回信息。
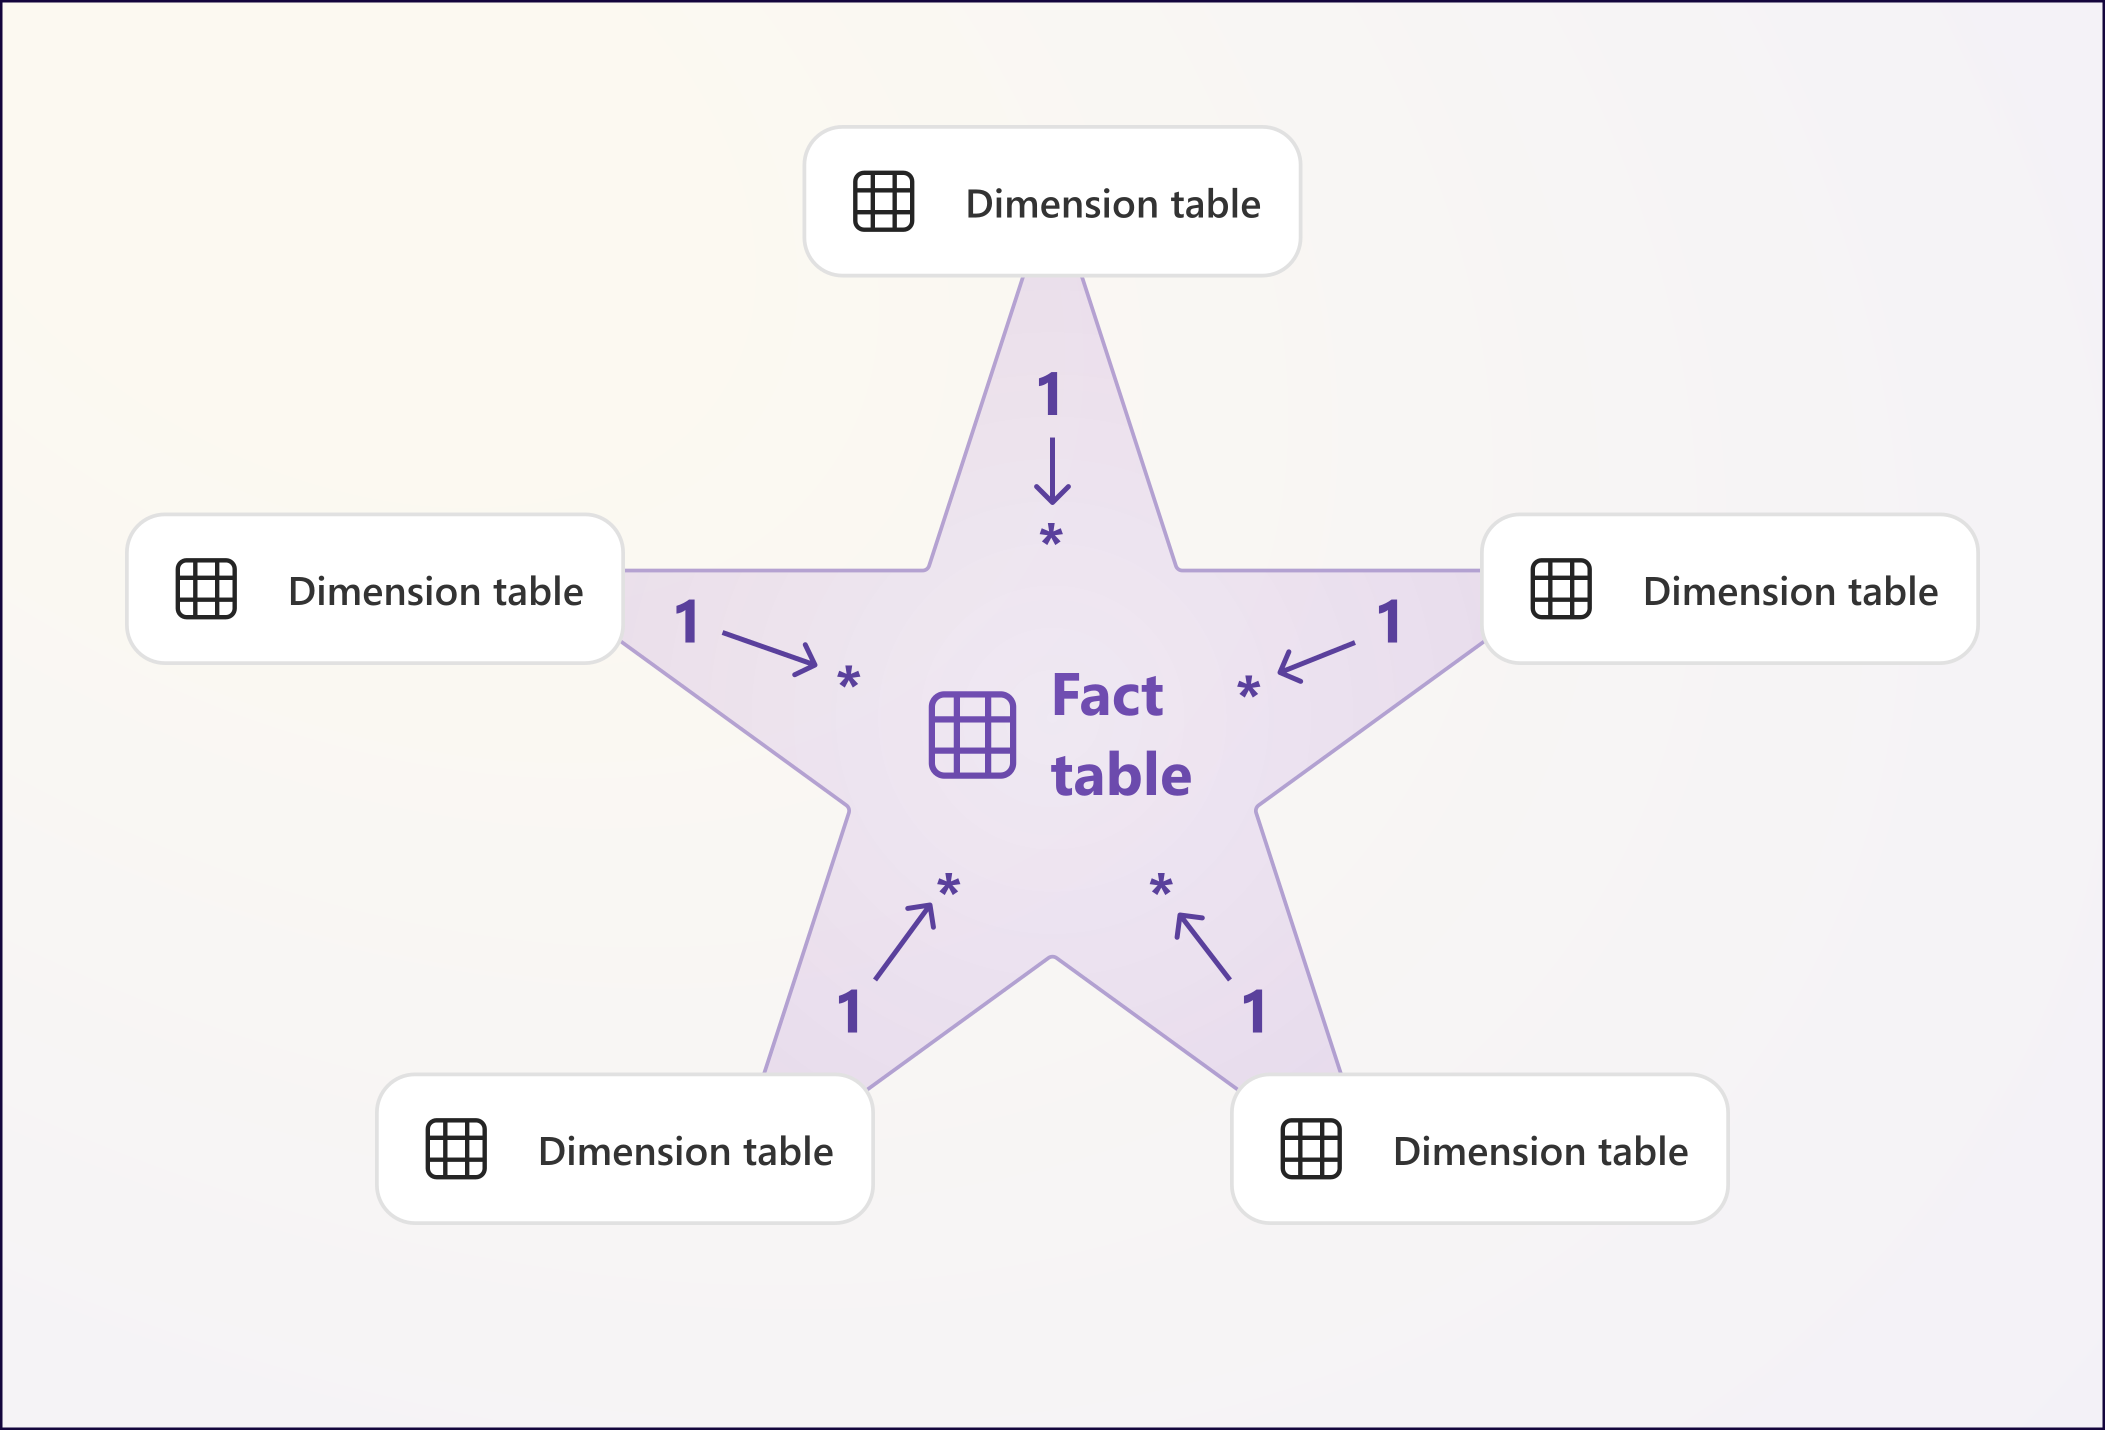
面向分析的语义层,通常会将底层数据整理成以事实为中心、由维度和指标组织起来的逻辑分析模型,下文称“语义模型”。它沿用星型模型的核心思想,让 AI 面向业务概念查询,再由系统处理底层关联与计算。
先看一张典型的星型模型图:
图片来源:Microsoft Learn:理解星型模型。
中间的 Fact table(事实表)记录业务发生了什么,例如一笔销售;周围的 Dimension table(维度表)提供观察角度,例如客户、商品、日期和地区。
这里的“向星型结构对齐”,发生在逻辑分析层。底层可以仍是现有业务表,日期也可以直接来自发票字段,无须另建日期表。语义模型负责整理来源与关联,并定义有效状态、分转元和汇总规则,为 AI 提供含义明确的销售分析入口。
整个语义层还可以包含销售、回款等多个分析主题,形成多颗相互关联的“星”;跨主题查询仍需协调各自粒度。
沿用客户和发票,几个常见概念可以这样理解:
| 要素 | 回答什么问题 | 本例 |
|---|---|---|
| 业务对象 | 分析围绕什么业务事物 | 发票、客户 |
| 粒度 | 一条事实代表什么 | 一张发票,而非一条商品明细 |
| 主键 | 怎样唯一识别对象 | invoice_id 识别发票,customer_id 识别客户 |
| 维度 | 从什么角度筛选、分组 | 客户、开票日期 |
| 属性 | 怎样描述业务对象 | 客户名称;同名客户仍靠 ID 区分 |
| 指标 | 要计算什么、怎样汇总 | 有效开票销售额 |
| 关联 | 对象怎样连接、是一对几 | 多张发票对应一位客户 |
属性也可以公开为筛选或分组字段,具体用途由语义模型定义。指标则需要明确计算与聚合规则,不能只列一个字段名。
“六月哪些客户销售额最高”,就是按日期筛选、按客户汇总销售额。
沿用小销售库,为本例的“有效开票销售额”写一张定义卡:
| 项目 | 本例定义 |
|---|---|
| 金额来源 | invoices.total_amount_cents,存储单位为分 |
| 统计粒度 | 一张发票,以 invoice_id 识别;每张只累计一次 |
| 有效条件 | status = 'ISSUED' |
| 日期口径 | 使用 invoice_date,按统一时区解释 |
| 汇总与单位 | 累加有效发票金额,再除以 100.0,得到元 |
| 客户关系 | 通过 customer_id 关联客户,一位客户可以有多张发票 |
| 可见范围 | 按系统提供的当前用户身份和权限限制数据 |
“查六月”“按客户分组”“取前三名”属于本次查询条件。查七月时,指标定义不变,日期范围变了。
含税、未税、退款等业务差异也要明确,必要时分别命名指标,不能指望所有人说的“销售额”天然是同一个数。
上面的卡片供人确认口径;要参与执行,还要转换为引擎认识的语义模型。下面是结构化定义示意,不是某个产品可直接加载的配置:
name: SalesInvoiceQueryModel
caption: 有效开票销售分析
object: invoice
source: invoices
primaryKey: invoice_id
fixedFilter: "status = 'ISSUED'"
dimensions:
  invoiceDate:
    column: invoice_date
    type: datetime
  customer:
    source: customers
    key: customer_id
    caption: customer_name
    join: "invoices.customer_id = customers.customer_id"
    relationship: many_to_one
metrics:
  salesAmount:
    expression: "invoices.total_amount_cents / 100.0"
    aggregation: sum
    type: decimal
    unit: 元
这里包含来源、主键、类型、过滤条件、关联关系和聚合表达式。加载时,系统将它们解析为语义模型对象,检查引用和表达式;查询时按这些定义组织计算。
写“单位为元”只是说明;expression 定义了单张发票的分转元,aggregation: sum 定义了汇总方式。系统依据这些规则生成计算,AI 不必每次重新决定这个字段是否除以 100。
建模人员确认口径、编写语义模型,再用已知结果验证。这些工作可以由 AI 辅助;语法检查通过,仍不代表业务口径正确。
sequenceDiagram
    participant B as 建模人员
    participant S as 语义层
    B->>S: 提交已审核的语义模型
    S->>S: 校验并加载
    B->>S: 用已知问题试查
    S-->>B: 返回结果,供核对与修正
语义模型加载后,系统按当前用户可见范围导出查询元数据,组织成 Markdown、JSON 或工具返回的描述,交给 LLM 使用。这里交付的是查询说明,而非完整的语义模型源文件;定义变更后,导出元数据也要同步更新。
导出的内容重点是:语义模型适合回答什么问题,字段怎样引用,单位和业务含义是什么,哪些字段能筛选、分组或聚合。物理表名、JOIN 表达式和内部权限配置,不必全部交给 LLM。
本例将客户关联的键和名称分别公开为 customerId、customerName;查询字段名可以与底层列名不同。
下面是该语义模型导出的 Markdown 简化示例。正式元数据还应包含字段的数据类型(如日期、数值、文本)等信息;示例字段名仅作说明,具体接口以实际公开名称为准:
# 有效开票销售分析
语义模型标识:SalesInvoiceQueryModel
语义模型名称:有效开票销售分析
适用:按开票日期分析有效发票销售额。

可查询字段:
- customerId:客户 ID,可分组;用它区分同名客户。
- customerName:客户名称,展示时与客户 ID 一起使用。
- invoiceDate:开票日期,支持日期范围筛选。
- salesAmount:单张发票金额,单位元,可求和。
LLM 据此把“六月销售额最高的客户”对应到日期、客户分组和金额求和,并用 SalesInvoiceQueryModel 指定查询目标。语义模型元数据怎样用于查询生成。
本次查询只需表达:按客户统计六月的 salesAmount,金额降序,客户 ID 升序,取前三名。这里先用文字表示意图,下一章再写具体请求。
建模不必随每次提问重复。用户提问后,LLM 结合查询元数据与协议组织请求;问题有歧义时先澄清。下图展示问题已明确的查询过程:
sequenceDiagram
    participant U as 用户
    participant A as LLM
    participant S as 语义层
    participant D as 数据库
    U->>A: 六月销售额最高的前三名客户?
    A->>S: 获取当前用户可见的查询元数据
    S-->>A: 返回语义模型标识及字段说明
    A->>S: 提交语义查询
    S->>S: 校验请求、落实权限、展开规则
    S->>D: 提交编译后的物理 SQL
    D->>D: 执行查询
    D-->>S: 返回结果或错误
    S-->>A: 返回数据、口径、范围与执行状态
    A-->>U: 依据结果回答,说明限制
其中,语义层的查询处理包括:
| 环节 | 本例怎样处理 |
|---|---|
| 字段绑定 | 将请求中的 customerId、salesAmount 绑定到语义字段及其物理来源 |
| 计算展开 | 按求和规则展开为 SUM(invoices.total_amount_cents / 100.0) |
| 过滤与关联 | 加入语义模型的 ISSUED 条件,按声明路径关联客户,并应用六月范围 |
| 聚合规划 | 按客户 ID、名称汇总,确保本次取数不展开为多条明细 |
| 校验与编译 | 拒绝不可用字段或不支持的组合,落实权限,生成目标数据库的查询 |
这些规则无须 LLM 在每次请求中重写:它没有填写有效状态条件,固定过滤仍应生效。报表或应用提交同样的语义请求,也会使用这些规则。
权限同样需要执行链路:可信身份提供用户范围,引擎或数据库施加约束。仅在描述里写“只能查本部门”,不会自动形成授权策略。
有些集成只用语义模型描述辅助 AI 生成物理 SQL。它能改善理解,却没有获得上述查询入口对业务规则的执行约束,两种用法需要分清。
销售额可以求和,其他指标却未必。假设再定义“平均每张有效发票金额”:
平均每张有效发票金额 = 有效开票销售额 ÷ 有效发票张数
按客户查询时,分子和分母都在各客户范围内计算;看六月总计时,要用全期总金额除以总张数。不能把各客户的平均值直接相加,也不能不看张数就取平均。
因此,语义模型不仅要说明字段叫什么,还要表达指标依赖、聚合方式和适用维度;执行器要在当前分组、筛选范围和计算阶段展开这些定义。指标不是预先算好的一个数,也不是给某列换个中文名。指标在查询上下文中求值的解释。
发票金额可以按客户汇总;扩展到商品时,一张发票却可能包含多种商品,不能把整张发票金额算给每一种商品。此时要明确按商品分摊的规则,或改用商品明细金额。
语义模型需要声明关联的基数(一对一、多对一或一对多)和指标适用的维度。引擎在支持范围内规划关联与汇总,无法可靠处理的组合应明确拒绝。只声明“发票关联明细”,不会自动解决重复累计。维度与指标粒度的约束示例。
本例查出的六月前三名客户销售额分别是 5500、4200、3000 元,合计 12700 元。AI 可以说“前三名客户合计 12700 元”,却不能说“六月总销售额为 12700 元”:查询只取了前三名。全体客户的六月合计是 13600 元,需要另一项汇总才能得到。
因此,查询工具返回数值时,还应保留指标、单位、筛选范围、是否截断和执行状态,供 AI 核对和说明。没有记录、金额为零和查询失败要分别处理;问题有歧义时先澄清,只有销售数据时,也不能凭空编出业绩变化的原因。语义层能提供依据与约束,最终回答仍需检查。
第二章已经用 SQL 修正了重复累计;视图、公共表达式和数据库策略也能复用规则。下面对比直接面向物理表生成 SQL 与通过语义层查询,看看工作怎样分配:
| 第二章的问题 | 直接生成物理 SQL | 通过语义层查询 |
|---|---|---|
| 分、元混用,口径不一致 | 在 SQL 或视图中落实换算与过滤 | 在语义模型中集中定义,由引擎展开 |
| 关联后重复累计 | 按粒度组织 JOIN 与汇总,核对结果 | 声明粒度与关联,由引擎在支持范围内规划;无法可靠处理时拒绝 |
| 旧字段与内部命名 | 整理 Schema,或用视图提供业务字段 | 公开确认过的语义字段,物理映射留在后台 |
| 权限处理复杂 | 使用数据库策略、受限视图,或解析改写 SQL | 对语义请求统一校验,结合执行引擎或数据库策略落实权限 |
| 查询复核困难 | 追查 SQL 中的字段来源、过滤与聚合 | 先核对语义定义与查询意图,再追溯实际 SQL |
上一章那些不方便念出来的字段名,也终于有机会留在幕后。
可以看到,语义层承担了大部分确定性工作,LLM 不必直接处理复杂的物理表结构、关联与计算细节,减少了犯错的概率。
规则有了统一的执行位置,LLM 还需要掌握查询接口。沿“自然语言 → DSL → SQL”这条路线,主要新增的门槛在 DSL(领域专用语言)的使用上:LLM 即使熟悉 SQL,也不能默认它熟悉某个系统自定义的 DSL。
查询元数据告诉它有哪些语义模型和指标,却不一定告诉它该怎样拼出合法请求。接入时需要提供两类上下文:
| 上下文 | 回答什么问题 |
|---|---|
| 查询元数据 | 查哪个语义模型、字段是什么意思、单位与可用分析范围是什么 |
| 查询协议 | 语义模型标识放在哪里,怎样选择字段、写过滤、分组、聚合、排序与分页 |
即使请求是合法 JSON,字段、操作符或计算阶段写错,仍然不能正确查询。第四章会用具体请求说明。
因此,要通过提示词、工具 Schema 和完整示例,让 LLM 知道这个接口的用法,包括支持什么、出错后怎样修正。复杂分析增加新操作后,协议说明与验证题库也要跟上;更换 LLM 时,也要重新验证适配效果。
放在一起看,直接查询物理表时,LLM 可以使用熟悉的 SQL,却要直面业务口径与表关系的复杂度;改用语义 DSL,业务含义清晰了,又需要教会 LLM 怎样使用查询协议。
语义层也可以提供 SQL 入口,让 LLM 面向虚拟业务表查询;本系列先用 DSL 学完整的问数流程,语义 SQL 留到高级篇“语义 SQL 与虚拟业务表”专题展开。
SQL 的表达能力很强,但部分复杂的分阶段或多维分析,用合适的 DSL 可以表达得更简洁。
我个人认为,随着 LLM 理解和推理能力增强,自定义 DSL 的适配门槛有望逐步降低。当 LLM 能够准确理解协议、拆解分析步骤时,就更能发挥 DSL 在复杂分析中表达简洁、边界清晰的优势。这些差异留到高级篇展开。
ETL 负责抽取、转换和加载,例如统一日期格式、处理重复记录、汇集不同来源的数据;语义层负责业务含义和查询规则。源数据漏了发票,语义模型再完整也算不回来。
中小企业可以先对现有业务表或视图建模,遇到数据质量、跨来源对齐问题,再补充必要的数据准备。多来源处理放到高级篇展开。
为“六月客户数量”补全三项定义:统计什么客户、按什么键去重、使用哪个日期。
在原始样例的全部数据范围内,“客户档案总数”是 5;“六月有有效发票的客户数”是 4。后者需要按开票日期和有效状态筛选,再按 customer_id 去重。即使一位客户有多张发票,也只能算一位。
两个数都可能算对,回答的是不同问题。语义层要把这种区别命名、定义清楚。
语义模型定义业务含义和执行规则,元数据与查询协议帮助 LLM 表达意图,引擎负责校验与编译,数据库执行计算。AI 再依据结果及其范围回答;查询成功,仍需检查答案是否如实。
采用自定义 DSL 时,还要解决 LLM 对查询协议的适配。下一章用同一个销售问题,写出具体请求,逐项对照生成的 SQL。
仍然查询“2025 年六月销售额最高的三位客户”。上一章已经定义了语义模型;现在看 LLM 怎样表达本次查询,以及引擎怎样把它转换为物理 SQL。
这条路线是:自然语言 → 语义 DSL → 物理 SQL → 数据库执行。
沿用上一章的 SalesInvoiceQueryModel:以发票为粒度,只统计有效发票,金额统一为元,并公开以下字段。
| 语义字段 | 含义及本例用法 |
|---|---|
customerId |
客户 ID,分组时区分同名客户 |
customerName |
客户名称,用于展示 |
invoiceDate |
开票日期,用于筛选 |
salesAmount |
单张有效发票金额,单位元,可以求和 |
LLM 先从当前用户可见的语义模型中选择,再读取查询元数据,确认字段、类型、单位与可用操作。
本次问题可以拆成:筛选六月、按客户分组、累计销售额、按金额降序取三位。金额并列时按客户 ID 升序,保证结果顺序稳定。
字段选对了,筛选值也要有依据:
查询元数据提供业务含义与已定义的映射;具体维度值可以按需查询,不必一次全部塞给 LLM。
元数据告诉 LLM“能查什么”,查询协议告诉它“怎样写请求”。为说明二者怎样配合,这里约定一套简化 DSL,用 JSON 承载查询意图,不作为某个产品的可执行接口:
{
  "model": "SalesInvoiceQueryModel",
  "columns": [
    "customerId",
    "customerName",
    "SUM(salesAmount) AS totalSales"
  ],
  "slice": [
    {
      "field": "invoiceDate",
      "op": "[)",
      "value": ["2025-06-01", "2025-07-01"]
    }
  ],
  "groupBy": ["customerId", "customerName"],
  "orderBy": ["-totalSales", "customerId"],
  "limit": 3
}
即使之前没用过这套协议,看到字段、分组、排序和条数,大概也能读出它想查什么。DSL 不必从零发明一套陌生语法,可以借助 JSON、YAML 等熟悉的格式表达领域含义:上一章用 YAML 定义语义模型,这里用 JSON 描述查询。需要学习的是具体的键名、操作符和执行含义。
在这套约定里,model 指定语义模型;columns 选择返回字段,支持求和及别名;slice 筛选聚合前的记录;groupBy 指定分组;orderBy 中的负号表示降序;limit 限制返回条数。
这里的 SUM 适用于可加总的单张发票金额。平均金额、比例等指标,应遵循语义模型公开的计算方式,不能一律求和。
[) 表示左闭右开区间,包含六月末尾,不包含七月一日。LLM 需要通过协议说明、工具 Schema 和示例获知这些写法。
同样是“超过三千元”,筛选对象不同,结果含义也不同:
| 用户问题 | 处理含义 |
|---|---|
| 只统计单张金额超过三千元的有效发票 | 先筛选发票,再汇总金额 |
| 找累计有效开票销售额超过三千元的客户 | 先按客户汇总,再筛选客户的汇总金额 |
在 SQL 中,两者通常分别用 WHERE 和 HAVING 表达。本章的简化 DSL 只示范了 slice 聚合前筛选;聚合后筛选需要查询协议另行支持,不能把汇总条件直接塞进 slice。
语义模型的有效状态和权限约束仍要生效;请求按需表达行筛选、分组、汇总后筛选、排序和条数。LLM 要分清这些阶段,引擎也要校验相应操作是否支持。
引擎先检查语义模型和字段是否可用、类型、字段组合与聚合是否合法,再根据可信身份落实权限。随后展开金额公式、加入固定过滤、组织客户关联,编译为目标数据库的 SQL。
下面用 SQLite 写出本例的等价物理 SQL,帮助读者核对规则落在了哪里。它是教学示意,不是某个引擎的真实编译输出。
SELECT
    c.customer_id,
    c.customer_name,
    SUM(i.total_amount_cents / 100.0) AS total_sales
FROM invoices AS i
JOIN customers AS c ON c.customer_id = i.customer_id
WHERE i.status = 'ISSUED'
  AND i.invoice_date >= '2025-06-01'
  AND i.invoice_date < '2025-07-01'
GROUP BY c.customer_id, c.customer_name
ORDER BY total_sales DESC, c.customer_id ASC
LIMIT 3;
其中,客户 JOIN、ISSUED 条件和 / 100.0 来自语义模型;六月范围、客户分组、排序与前三名来自本次请求。
在小销售库中执行这段 SQL,结果仍为:
| 客户 | 销售额(元) |
|---|---|
| 华东食品 | 5500.00 |
| 远山商贸 | 4200.00 |
| 青禾便利 | 3000.00 |
本例使用全部样例数据,实际结果还取决于当前用户的数据范围。LLM 回答时,应保留“2025 年六月”“有效开票销售额”“前三名”等信息。
如果 LLM 把 customerName 写成 clientName,当前语义模型没有这个字段,请求应在校验阶段被拒绝。
LLM 根据诊断重新读取查询元数据,确认是拼写错误、字段未公开,还是选错了语义模型,再修正请求。不能仅凭名字相近就替换,也不能为绕过权限退回物理表查询。
诊断可以帮助修正无效字段,却未必识别业务选择错误。比如用户问回款,LLM 却选择了有效开票销售额,字段和语法都可能合法,仍需核对查询意图。
LLM 理解问题、选择语义模型并表达本次查询;引擎依据语义定义校验与编译,数据库完成计算,LLM 再按实际结果回答。业务规则由系统落实,查询意图和回答仍需要核对。
下一章把直接 Text-to-SQL 与语义层查询放在一起,讨论不同场景怎样选择,以及怎样组织完整的问数系统。
本章样例与核对方法提供请求示意、等价 SQL 与核对范围。
前四章介绍了两条路线:直接生成物理 SQL,或通过语义 DSL 查询。本章先根据使用者和问题选择起点,再看怎样组合工具、语义能力和多步分析。
如果服务的是日常与 SQL 打交道的技术人员或数据分析师,他们熟悉业务库,能够审查生成的 SQL 和结果,直接 Text-to-SQL 是合适的起点,也便于探索新问题。
如果目标用户不懂 SQL,甚至不了解数据库概念,更适合先通过语义层整理业务口径与可查询范围,让他们围绕业务概念问数。即使使用者会 SQL,团队反复使用统一指标、需要多人稳定问数时,也值得采用语义层,减少重复定义与维护。
这有点像用户要查数据时,你是给他一个 SQL 客户端,让他自己组织查询,还是提供口径已经确认的报表,让他直接看业务结果。语义层还可以在已定义的范围内支持灵活提问和追问,而不局限于固定报表。
两种方式可以并存:技术人员先探索新问题,再把确认过的常用定义沉淀到语义层。
决定采用语义层后,先看已有工具和数据环境能提供哪些能力:
| 组合方式 | 业务定义与执行在哪里 | LLM 怎样参与 |
|---|---|---|
| 复用已有分析系统 | 使用已经确认的维度、指标、关联和查询接口 | 读取元数据,选择字段与条件,调用已有查询能力 |
| 接入独立语义查询服务 | 由服务加载语义模型,统一校验与执行 | 调用语义查询工具,与报表等入口复用定义 |
| 利用数据平台内的语义能力 | 在数据平台中维护指标及其访问规则 | 围绕平台公开的业务查询面组织请求 |
这些方式可以组合,也可以分步建设。已有合适的语义模型与接口,就先核对能否复用;若要提供语义查询,而手头只有原始业务表,就需要补上业务定义和查询能力。不能因为产品名字里有“AI”或“语义”,就省掉实际核对。
CLI、API 或工具协议解决的是怎样调用能力。一个工具可能只返回表结构,也可能执行物理 SQL,或接受上一章的语义查询。这些接口都能被 LLM 调用,承担的工作却不同。
接入时至少看清三件事:
“六月客户前三名”可能一次查询就够;“销售变化主要来自哪些客户”,往往需要先比较两个月的汇总,再按客户拆解变化,核对客户差额是否与总差额一致。
负责多步任务的 AI 助手,通常称为 Agent,在这里安排步骤、调用工具并检查中间结果。它可以使用同一个语义服务,也可以组合已有分析工具。语义层则负责每次查询所用的业务定义与执行规则,两者可以配合。
仍用“2025 年六月销售额最高的三位客户”检查:LLM 提交了什么查询,系统在哪里落实有效状态和分转元,结果适用于哪个用户范围,最后的回答是否保留了这些含义。
再追问“为什么第一名更高”,看系统会不会检查可用数据、补充查询或说明证据不足。界面能回答第一句话,不等于已经具备持续分析的能力。
选择路线时,要同时看使用者审查 SQL 与结果的能力、指标复用和交付要求。采用语义层后,可以复用已有分析系统,也可以接入独立服务;Agent 可以组织多步分析,查询仍经过相应执行入口。
技术篇到这里结束。应用篇从确定首批问题和验收范围开始,动手完成一个小型问数项目。